새 AI 모델이 나오면 보통 얼마나 똑똑해졌는지를 먼저 봅니다. 그런데 이번 발표는 읽는 각도를 조금 바꿔야 합니다.
결론부터 세 줄로 정리하면 이렇습니다. 오픈AI가 2026년 9월 22일 현지시간 GPT-6 솔과 루나를 공개했습니다. 벤치마크 최고 점수를 노린 모델이 아니라 같은 작업을 훨씬 싸게 처리하는 데 초점을 맞췄습니다. 같은 시기 앤트로픽도 클로드 오퍼스 5.5를 내놓으면서 가격 경쟁이 본격화되는 모양새입니다.
이번 글에서는 공개된 수치를 기준으로 무엇이 달라졌는지 정리해 보겠습니다.
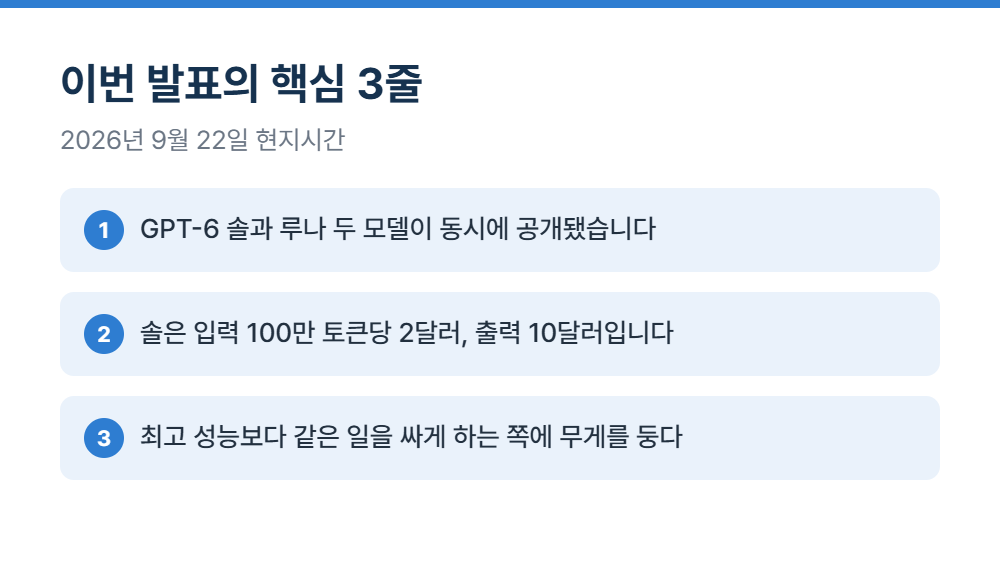
두 모델이 함께 공개됐습니다
이번에 나온 것은 GPT-6 솔과 GPT-6 루나입니다. 하나는 복잡한 작업을 맡는 상위 모델이고, 다른 하나는 대량 처리를 겨냥한 경량 모델입니다.
API에서는 각각 gpt-6-sol과 gpt-6-luna라는 이름으로 제공됩니다. 챗GPT에서는 플러스와 프로, 비즈니스, 엔터프라이즈, 에듀 사용자가 챗GPT 워크와 코덱스 환경에서 쓸 수 있고, 데스크톱 앱에서는 루나가 무료 사용자에게도 제공되는 것으로 안내됐습니다.
가격이 이번 발표의 핵심입니다
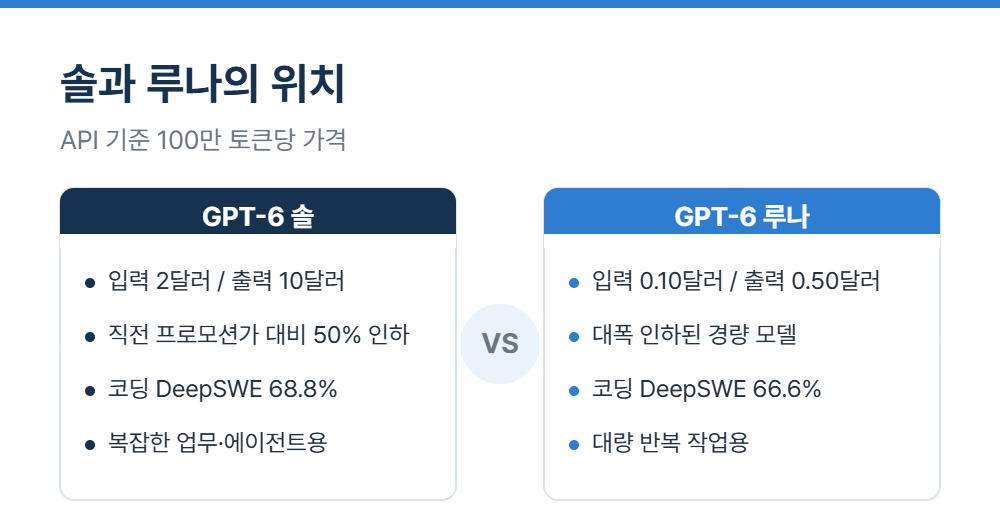
100만 토큰을 기준으로 한 API 가격은 아래와 같습니다.
| 모델 | 입력 100만 토큰 | 출력 100만 토큰 |
|---|---|---|
| GPT-6 솔 | 2달러 | 10달러 |
| GPT-6 루나 | 0.10달러 | 0.50달러 |
솔의 가격은 직전 GPT-5.6 프로모션 가격과 비교해 50퍼센트 인하된 수준입니다. 루나는 그보다 훨씬 아래에 자리를 잡았습니다.
여기에 프롬프트 캐싱으로 재사용되는 토큰에는 90퍼센트 할인이 적용됩니다. 오픈AI는 단순한 토큰 단가 인하가 아니라 캐싱과 추론 효율 개선을 통해 대규모 업무와 장시간 에이전트 대화의 비용을 근본적으로 낮추는 데 목적이 있다고 설명했습니다.
성능은 최고가 아닙니다
솔직하게 짚으면 절대 성능에서 1위를 차지한 모델은 아닙니다. 평가 기관 아티피셜 애널리시스 기준으로 살펴본 수치는 이렇습니다.
- 지능 지수: 솔 48점으로 전체 6위, 같은 계열 아스트라는 53점
- 전문 직무 역량 평가: 솔 49퍼센트, 클로드 오퍼스 5.5는 67퍼센트, 아스트라는 52퍼센트
- 터미널 제어 평가: 솔 44퍼센트, 오퍼스 5.5는 60퍼센트, 아스트라는 59퍼센트
- 지식 정확도 평가: 솔 54퍼센트
즉 어려운 문제를 가장 잘 푸는 모델을 찾는다면 이번 발표의 주인공은 아닙니다. 이 지점이 지난 GPT-6 아스트라 수능 만점, AGI 도래인가? 쟁점 정리 때의 분위기와 확연히 다른 부분입니다.
대신 비용 효율에서 격차를 벌렸습니다
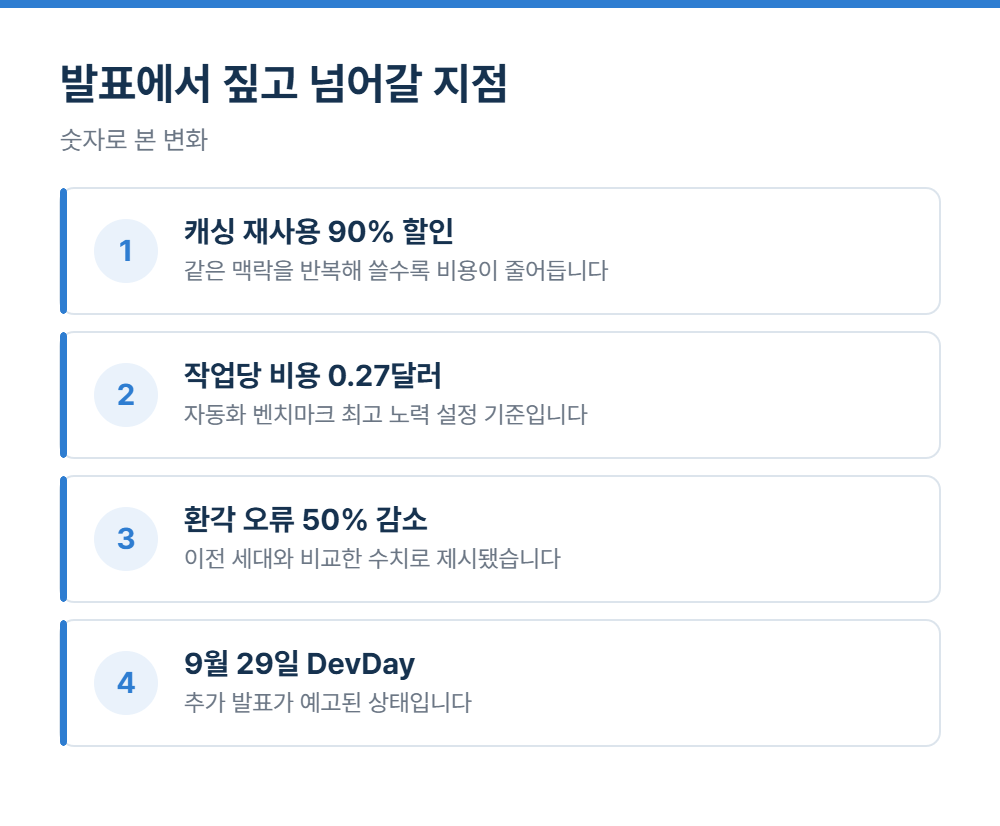
같은 자료에서 비용 쪽 수치를 보면 이야기가 달라집니다.
자동화 벤치마크의 최고 추론 노력 설정에서 솔은 작업당 0.27달러를 기록했습니다. 코딩 평가에서는 솔이 68.8퍼센트로 최상위 모델과 비슷한 수준을 내면서 작업당 비용은 약 80퍼센트 절감됐다고 제시됐습니다.
루나는 코딩 평가에서 66.6퍼센트를 기록했는데, 비용은 비교 대상 상위 모델 대비 90퍼센트 이상 저렴한 것으로 나왔습니다. 컴퓨터 제어 평가에서도 솔은 60.5퍼센트로 상위권과 유사한 결과를 내면서 비용은 크게 낮췄습니다.
환각 문제도 함께 언급됐습니다. 솔은 이전 세대와 비교해 오류 발생이 50퍼센트가량 줄어든 것으로 제시됐습니다.
앤트로픽도 같은 주에 움직였습니다
이번 발표를 오픈AI 혼자만의 이야기로 보기는 어렵습니다. 비슷한 시점에 앤트로픽도 클로드 오퍼스 5.5를 공개하면서 가격을 40퍼센트 내린 것으로 보도됐습니다.
앞서 본 전문 직무 역량 평가에서 오퍼스 5.5가 67퍼센트로 가장 높은 수치를 기록한 점을 함께 놓고 보면 구도가 드러납니다. 한쪽은 성능 상단을 끌어올리고, 다른 한쪽은 같은 성능대의 가격을 끌어내리는 방식으로 맞붙고 있는 셈입니다.
이용자 입장에서는 선택지가 늘어나는 국면입니다. 다만 모델을 자주 바꾸면 결과물의 성격도 달라지므로, 비용만 보고 옮기기보다 검증 기준을 함께 두는 편이 안전합니다.
왜 가격을 앞세웠을까요
배경을 짚으면 이해가 쉽습니다. AI 활용이 대화형에서 에이전트형으로 넘어가면서 한 번의 작업에 소모되는 토큰이 급격히 늘었습니다.
자동으로 여러 단계를 수행하는 작업은 대화 한 번으로 끝나지 않습니다. 이때 토큰 단가가 그대로라면 도입 자체가 부담이 됩니다. 에이전트 확산의 병목이 성능이 아니라 비용이라는 진단이 담긴 발표로 볼 수 있습니다.
자율 수행형 AI가 어떤 흐름으로 확산되고 있는지는 개인용 AI 에이전트란? 메타 뮤즈 공개로 본 자율 수행 AI에서 함께 다뤘습니다.
숫자를 읽을 때 주의할 점
발표에 등장한 수치는 대부분 특정 벤치마크와 특정 설정에서 나온 값입니다. 추론 노력을 어느 수준으로 두느냐에 따라 점수와 비용이 같이 움직입니다.
따라서 작업당 비용이 얼마라는 숫자도 그 설정을 전제로 한 값으로 읽어야 합니다. 내 업무에서 같은 비율로 절감된다는 보장은 없습니다.
벤치마크 자체의 신뢰성 문제도 최근 제기되고 있습니다. 개발 속도를 둘러싼 논의는 프론티어 페이싱이란? AI 개발 속도 조절 논쟁 정리에서 다룬 바 있습니다.
실무에서 확인할 체크리스트
- 지금 쓰는 작업이 최고 성능이 필요한 일인지, 반복 처리인지 구분했는가
- 반복 작업이라면 경량 모델로 옮겼을 때의 비용 차이를 계산해봤는가
- 같은 맥락을 반복해 넣는 구조라면 캐싱 할인을 활용할 수 있는가
- 모델 교체 시 출력 품질을 검증할 기준을 가지고 있는가
- 벤치마크 점수만으로 판단하지 않고 실제 업무로 시험해봤는가
자주 묻는 질문
Q. 솔이 아스트라보다 좋은 모델인가요
평가 점수만 보면 아스트라가 더 높습니다. 솔은 비슷한 일을 더 싸게 처리하는 쪽에 초점이 있습니다.
Q. 루나는 무료로 쓸 수 있나요
데스크톱 앱에서 무료 사용자에게도 제공되는 것으로 안내됐습니다. API로 쓸 때는 사용량만큼 과금됩니다.
Q. 캐싱 할인은 자동으로 적용되나요
재사용되는 토큰에 적용되는 구조입니다. 매번 다른 내용을 넣는 방식이라면 할인 효과는 제한적입니다.
Q. 다음 발표는 언제인가요
9월 29일 DevDay 2026에서 추가 발표가 예고된 상태입니다.
정리
- GPT-6 솔과 루나가 2026년 9월 22일 현지시간 공개됐습니다.
- 솔은 입력 2달러, 출력 10달러로 직전 대비 50퍼센트 인하된 가격입니다.
- 최고 성능이 아니라 같은 작업의 비용을 낮추는 데 무게를 둔 발표입니다.
참고: AI타임스 보도
'IT·AI 소식' 카테고리의 다른 글
| 불법스팸 과징금 10월 시행|매출액 최대 6%, 무엇이 달라지나 (0) | 2026.09.23 |
|---|---|
| AI 벤치마크 점수는 믿을 만한가|15개 중 9개서 결함 발견 (0) | 2026.09.23 |
| 프로젝트 팔랑크스|AI가 방어하는 국제 사이버 훈련 정리 (0) | 2026.09.18 |
| EU 키즈 액트|13세 미만 SNS 금지, AI 챗봇도 규제 대상 (0) | 2026.09.18 |
| AI가 370년 미해결 암호를 44분 만에 풀었습니다 (0) | 2026.09.16 |