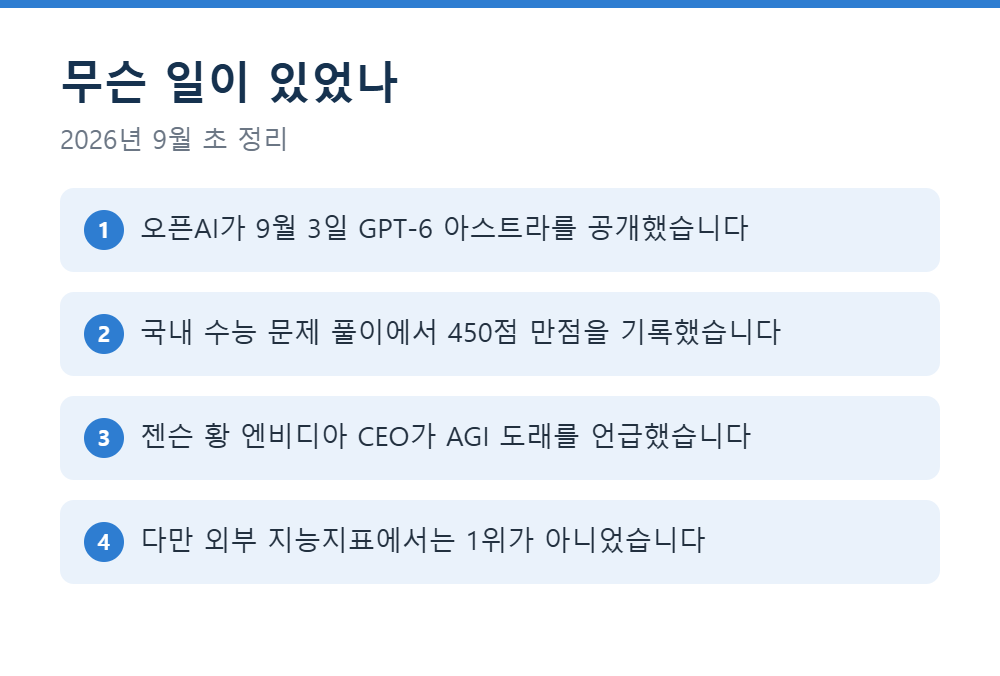
오픈AI가 현지시간 9월 3일 공개한 GPT-6 아스트라(Astra)가 국내 수능 문제 풀이에서 전 과목 만점을 기록하면서 AGI 논쟁이 다시 불붙었습니다.
젠슨 황 엔비디아 CEO는 9월 7일 "AGI가 도래했다"며 오픈AI 팀에 축하를 보냈고, 오픈AI 경영진도 비슷한 취지의 평가를 내놨습니다. 반면 외부 평가 지표에서는 아스트라가 1위가 아니어서 판단이 갈리고 있습니다.
이번 글에서는 실제로 무슨 일이 있었는지, 이 성적을 어떻게 읽어야 하는지, 그리고 실무자 입장에서 무엇이 달라지는지 정리했습니다.
무슨 일이 있었나요?
국내 개발자 커뮤니티에서 운영되는 '2026 수능 LLM 풀이 기록'에서 아스트라가 국어·영어·수학·한국사와 탐구 4과목을 외부 검색 없이 풀어 종합 450점 만점을 받았습니다.
AI 모델이 수능 전 과목에서 만점을 기록한 것은 이번이 처음으로 알려졌습니다. 직전 세대인 GPT-5.6이 448.5점, 클로드 페이블 5.1이 447.5점이었으니 격차 자체가 큰 것은 아닙니다.
다만 만점이라는 상징성 때문에 반응은 컸습니다. 여기에 업계 인사들의 AGI 발언이 겹치면서 논쟁이 확산됐습니다.
누가 어떤 말을 했나요?
| 인물 | 발언 요지 |
| 젠슨 황 (엔비디아 CEO) | "AGI가 도래했다"며 오픈AI 팀에 축하를 전함 |
| 샘 올트먼 (오픈AI CEO) | 컴퓨터 사용, 전문 업무, 과학, 코딩, 사이버보안 영역에서 최고 수준이라 평가 |
| 그레그 브록먼 (오픈AI 사장) | 인간이 컴퓨터로 하는 일이라면 무엇이든 가능하다며 첫 AGI로 보는 것이 합리적이라 주장 |
주목할 점은 이 발언들이 모두 모델을 만들거나 그 생태계에 이해관계가 있는 쪽에서 나왔다는 것입니다. 평가를 읽을 때 감안해야 할 부분입니다.
그런데 지능지표에서는 1위가 아니었습니다
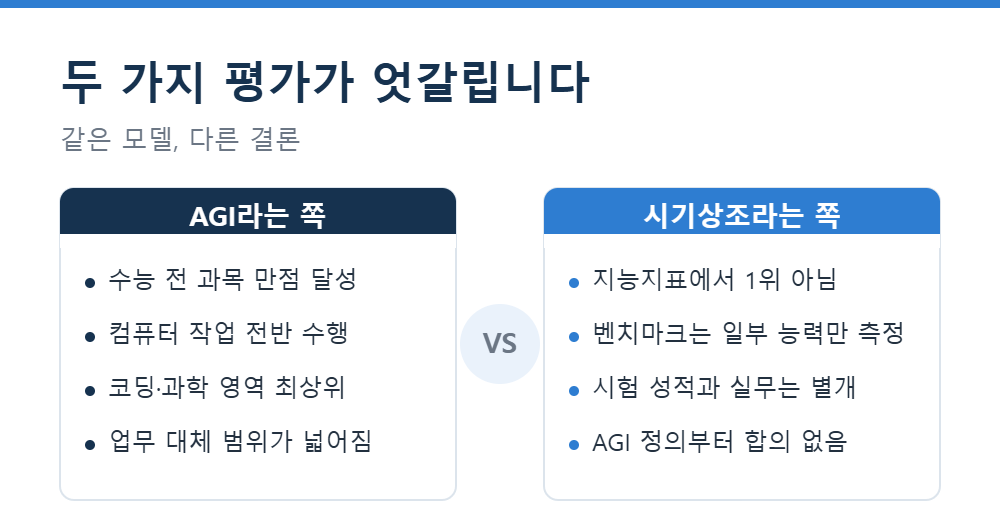
외부 평가기관 아티피셜 애널리시스의 지능지표(AAII)에서 아스트라는 55점을 받아, 57점을 기록한 클로드 페이블 5.1에 미치지 못했습니다.
같은 모델이 한 평가에서는 사상 첫 만점, 다른 평가에서는 2위인 셈입니다. 모순처럼 보이지만 두 평가가 측정하는 것이 다르기 때문에 충분히 나올 수 있는 결과입니다.
수능은 정답이 정해진 문제를 얼마나 정확히 푸는지를 봅니다. 종합 지능지표는 추론, 장문 처리, 도구 사용 등 여러 항목을 묶어 평가합니다. 강점이 다른 모델이 각각 다른 지표에서 앞설 수 있습니다.
AGI 논쟁의 두 입장
도래했다는 쪽
인간이 컴퓨터로 수행하는 작업 대부분을 처리할 수 있다면 그것으로 충분하다는 입장입니다. 특정 영역의 초인적 능력보다 적용 범위의 넓이를 기준으로 봅니다.
아직 이르다는 쪽
시험 성적은 훈련 데이터와 유사한 문제에서 강할 수밖에 없다는 반론입니다. 새로운 상황에서의 일반화, 장기 과제 수행, 자기 오류 인식 같은 부분이 검증되지 않았다고 봅니다.
사실 AGI라는 말 자체에 합의된 정의가 없습니다. 정의가 다르니 같은 성능을 두고 결론이 갈리는 것은 자연스러운 일입니다.

벤치마크 점수를 어떻게 읽어야 할까요?
모델 발표 때마다 점수가 쏟아지지만, 그 숫자가 내 업무에서의 성능을 보장하지는 않습니다. 아래 항목을 확인하면 과장된 해석을 걸러낼 수 있습니다.
- ☐ 그 벤치마크가 실제로 무엇을 측정하는지 확인했다
- ☐ 외부 검색·도구 사용이 허용된 조건인지 확인했다
- ☐ 여러 번 시도한 결과 중 최고값인지 확인했다
- ☐ 다른 독립 평가기관의 지표와 대조해 봤다
- ☐ 평가 주체가 이해관계자인지 확인했다
- ☐ 내 실제 업무 데이터로 직접 테스트해 봤다
마지막 항목이 가장 중요합니다. 벤치마크 1위 모델이 특정 업무에서는 다른 모델보다 못한 경우가 흔합니다.
실무에서는 무엇이 달라질까요?
상황 1. 문서·보고서 작업이 많은 조직
정형화된 문서 작업의 자동화 범위가 넓어지는 흐름은 분명합니다. 다만 결과물 검수 절차를 함께 설계하지 않으면 오류가 그대로 흘러갈 수 있습니다.
사내 자료를 AI에 입력할 때 지켜야 할 기준은 AI 챗봇에 회사 자료를 넣어도 될까? 입력 전 확인할 4가지에 정리해 두었습니다.
상황 2. AI를 업무 시스템에 연결하려는 경우
모델 성능이 올라갈수록 자율적으로 작업을 수행하는 구조가 늘어납니다. 이때 권한 관리와 로그 확보가 함께 가지 않으면 위험이 커집니다.
관련 논의는 AI 에이전트 보안, 왜 가시성이 핵심일까? 도입 전 점검 사항에서 다뤘습니다.
자주 묻는 질문
Q. 수능 만점이면 사람보다 똑똑한 건가요?
정해진 답이 있는 문제 풀이에서 뛰어나다는 의미입니다. 답이 정해지지 않은 문제나 장기 과제 수행 능력은 별개로 봐야 합니다.
Q. AGI에 합의된 정의가 있나요?
없습니다. 기관과 연구자마다 기준이 달라, 같은 모델을 두고 판단이 엇갈리는 주된 이유가 됩니다.
Q. 국내 AI 정책은 어떻게 되어 있나요?
2026~2028년을 대상으로 하는 국가 계획이 마련돼 있습니다. 내용은 인공지능 행동계획이란? 2026~2028 국가 AI 기본계획 정리에서 확인하실 수 있습니다.
Q. 지금 쓰는 모델을 바꿔야 하나요?
발표 시점의 순위는 자주 바뀝니다. 실제 업무 과제로 비교해 보고 결정하는 편이 안전합니다.
정리
아스트라의 수능 만점은 분명 의미 있는 기록이지만, 그 자체가 AGI 도달의 증거는 아닙니다. 같은 모델이 다른 평가에서는 1위가 아니었다는 사실이 이를 보여 줍니다.
- 수능 450점 만점은 정답이 있는 문제에서의 정확도를 보여 주는 지표입니다
- 독립 평가기관의 종합 지능지표에서는 경쟁 모델이 앞섰습니다
- AGI 정의에 합의가 없어 같은 결과를 두고 해석이 갈립니다
'IT·AI 소식' 카테고리의 다른 글
| 보안 특화 AI 파운데이션 모델이란? 네이버·LG 700B 모델 정리 (0) | 2026.09.11 |
|---|---|
| AI 데이터센터 특별법 하위법령, 무엇이 논의되나 (0) | 2026.09.10 |
| 반도체 특화 AI란? 삼성전자·미스트랄 협력으로 본 제조 AI (0) | 2026.09.09 |
| AI로 만든 콘텐츠, 표시해야 할까? 워터마크 의무 정리 (0) | 2026.09.09 |
| AI 바우처란? 중소기업 AI 도입 지원사업 구조 정리 (0) | 2026.09.09 |